🔍 درک گامبهگام مکانیزم ترنسفورمر با یک مثال ساده
🎯 وظیفه: ترجمه ماشینی
📥 جمله ورودی (انگلیسی): “Hello, how are you?”
📤 جمله هدف (فارسی): “سلام، حال شما چطور است؟”
بیایید با هم ببینیم ترنسفورمر چگونه این ترجمه را انجام میدهد👇
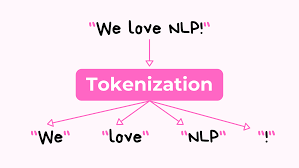
🟢 گام ۱: توکنیزهکردن (Tokenization)
هر کلمه یا زیرکلمه تبدیل به یک عدد منحصربهفرد میشود.
مثال:
“you” → 2017
🟢 گام ۲: جاسازی (Embedding)
هر عدد تبدیل به یک بردار (vector) با معنای زبانی میشود.
مثال:
“how” → [-0.56, 0.33, 0.11, …]
🟢 گام ۳: رمزگذاری مکانی (Positional Encoding)
ترنسفورمر ترتیب کلمات را نمیداند، بنابراین با استفاده از توابع سینوسی و کسینوسی، اطلاعات موقعیت هر کلمه را به بردار آن اضافه میکنیم.
مثال:
| کلمه | جاسازی اولیه | موقعیت | بردار نهایی |
|---|---|---|---|
| how | [-0.56, 0.33] | [0.04, 0.12] | [-0.52, 0.45] |
🟢 گام ۴: توجه به خود (Self-Attention)
مدل بررسی میکند هر کلمه چقدر باید به سایر کلمات توجه کند.
مثال:
“how” → بیشترین توجه به “are” و “you”
فرمول:
Attention(Q, K, V) = softmax(QKᵀ / √d_k) * V
🟢 گام ۵: چندسر توجهی (Multi-Head Attention)
مدل از چند «سر» یا زاویه متفاوت به جمله نگاه میکند:
- Head 1: نقش دستوری
- Head 2: معنای واژه
- Head 3: ساختار جمله
هر سر وزنهای توجه خودش را تولید میکند و در پایان، خروجیها با هم ترکیب میشوند.
🎯 چرا مفید است؟
چون یک رابطه را میتوان از چند زاویه تحلیل کرد (مثل دیدن یک شی از چند دوربین).
🟢 گام ۶: شبکهی پیشخور (Feedforward Network)
برای هر بردار خروجی از مرحله قبل، یک شبکه دو لایه (Dense) اعمال میشود:
FFN(x) = ReLU(W₁x + b₁)W₂ + b₂
🎯 فایده: یادگیری ویژگیهای پیچیدهتر و غیرخطی
🟢 گام ۷: جمع و نرمالسازی (Add & Norm)
برای پایداری آموزش، نتیجه مرحله قبلی با ورودی جمع شده و نرمال میشود:
Output = LayerNorm(Input + Attention_Output)
🎯 مزیت: کمک به جلوگیری از محو شدن گرادیانها (Vanishing Gradients)
🟢 گام ۸: تکرار چند لایهای
مراحل ۴ تا ۷ چند بار (مثلاً 6 یا 12 بار) در ساختار ترنسفورمر تکرار میشوند.
🎯 چرا؟
تا مدل بتواند مفاهیم عمیقتر و روابط بلندمدتتری را یاد بگیرد.
🟢 گام ۹: رمزگشا + توجه متقاطع (Decoder & Cross-Attention)
در این مرحله، مدل شروع به تولید ترجمه فارسی میکند. اما:
❗️ رمزگشا (Decoder) علاوه بر توجه به خودش، باید به خروجی رمزگذار (Encoder) هم نگاه کند.
مثال:
- “Hello” (ورودی) → “سلام” (خروجی) → توجه = 0.9
- “how” → “چطور” → توجه = 0.85
🎯 نتیجه: مدل مطمئن میشود ترجمه با متن اصلی هماهنگ است.
🟢 گام ۱۰: تولید خروجی نهایی (Final Output)
مدل در نهایت توکنهای خروجی را به کلمات فارسی بازگردانده و جمله کامل میسازد:
[501, 234, 678, 987, 345, 123, 789]
→ “سلام، حال شما چطور است؟”
✅ خلاصه تصویری گامها (گام، فرآیند و هدف):
| 1 | Tokenization | تبدیل کلمات به اعداد |
| 2 | Embedding | تبدیل اعداد به بردارها |
| 3 | Positional Encoding | افزودن اطلاعات ترتیبی |
| 4 | Self-Attention | بررسی روابط درونجمله |
| 5 | Multi-Head Attention | بررسی از چند دیدگاه |
| 6 | Feedforward | استخراج ویژگیهای پیشرفته |
| 7 | Add & Norm | تثبیت و پایداری یادگیری |
| 8 | Repeat for Layers | یادگیری مفاهیم عمیقتر |
| 9 | Cross-Attention | تطبیق منبع و ترجمه |
| 10 | Output | تولید متن نهایی |
📌 این دقیقاً کاریست که Google Translate یا ChatGPT انجام میدهند.
✅ ترکیبی از ریاضی، زبان و معماریهای عمیق یادگیری!