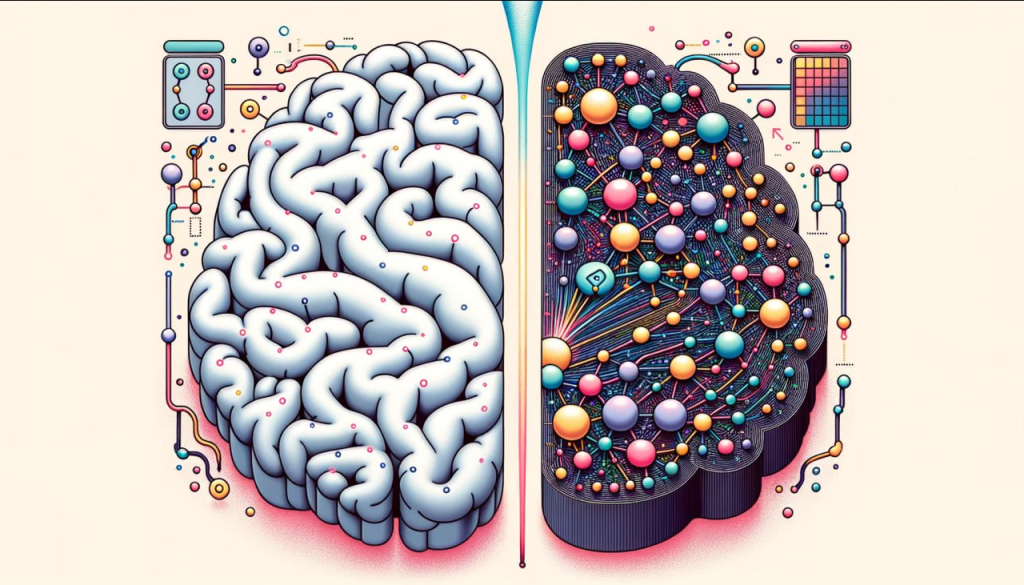
🧠✨ درون مغز یا درون مدل زبانی (هوش مصنوعی)؟
روایت عصبشناسیِ GPT، گام به گام با نورون و ریاضی
مدلهای زبانی مثل GPT با ماتریس و بردار کار میکنند.
اما در مغز انسان، چیزی بهظاهر متفاوت در جریان است: سلولهای زنده، الکتریسیته زیستی، و شیمی پیچیده.
اما آیا در عمق، هدف و روش یکیست؟
بیایید مغز و مدل را کنار هم بگذاریم؛
بردار در برابر ولتاژ، Attention در برابر Dopamine،
و ببینیم هر گام از مدل زبانی چگونه در مغز تکرار میشود — با نورون، سیناپس، و یون.
🔹 گام ۱: Embedding — واژهها تبدیل میشوند به بردارها / پترنهای نورونی
در GPT، «سیب» یعنی [0.2, 0.8, 0.1]
در مغز، «سیب» یعنی:
- فعال شدن نورونهای خاص در نواحی شنوایی، بینایی، و معنایی
- مثل نورون A32 در قشر شنوایی، نورون IT17 در قشر بینایی، و نورونهای MTG در معنیسازی واژهها.
هر واژه، یک «الگوی فعالسازی» نورونی دارد — درست مثل یک بردار.
🧪 از دید فیزیولوژی:
- هر نورون دارای پتانسیل غشایی است.
- زمانیکه پیام عصبی (ورودی) برسد، کانالهای سدیم (Na⁺) باز میشوند.
- ورود یونهای سدیم باعث دپولاریزاسیون میشود.
- اگر آستانه رد شود، نورون شلیک میکند (spike).
- سپس با خروج پتاسیم و ورود کلسیم (Ca²⁺) در پایانه آکسون، انتقال سیناپسی انجام میشود.
این همان چیزیست که مدل آن را «فعال شدن بُرداری» مینامد.
🔹 گام ۲: Positional Encoding — ترتیب کلمات کجاست؟
در LLM، برای درک ترتیب، بردار موقعیت اضافه میشود.
در مغز، زمانبندی فعالسازی نورونها (Temporal Coding) نقش اصلی دارد.
مثلاً:
- «من» → نورون A1 در ۲۰ میلیثانیه فعال
- «کتاب» → نورون B2 در ۶۰ میلیثانیه بعد
این تأخیر زمانی بین شلیک نورونها، ترتیب را کد میکند — همان چیزی که مدل با جمع بردار موقعیت انجام میدهد.
⏱️ مغز از پدیدههایی مثل Spike-Timing Dependent Plasticity (STDP) استفاده میکند تا وابستگی زمانی بین نورونها را بیاموزد.
🔹 گام ۳: Attention — توجه به کجاست؟
در GPT، هر کلمه به بقیه نگاه میکند و وزن میدهد (attention score).
در مغز، توجه توسط شبکهای از نورونها و انتقالدهندههای عصبی (مثل دوپامین و استیلکولین) هدایت میشود.
🔬 مکانیسم زیستی:
- قشر پیشپیشانی (PFC) تعیین میکند که روی کدام ورودی تمرکز شود.
- سیگنالهایی از PFC به تالاموس و نواحی حسی فرستاده میشود.
- این سیگنالها سطح کلسیم در سیناپس را تغییر میدهند → قدرت سیناپسی بالا یا پایین میرود.
مثلاً:
- اگر واژه «خطر» در جمله باشد، آمیگدال شدت پاسخ نورونهای مربوط به آن را افزایش میدهد.
این معادل همان weight بالای attention در مدل زبانی است.
🔹 گام ۴: Residual + Normalization — حفظ حافظه + تعادل فعالیت
در LLM، خروجی لایه قبلی با لایه جدید جمع میشود (Residuals) و نرمال میگردد.
در مغز، مشابه این فرآیند با بازخورهای عصبی (Feedback Loops) و تعدیل سیناپسی اتفاق میافتد.
🧠 مثال زیستی:
- ناحیه بینایی پیام را به حافظه کوتاهمدت میفرستد
- حافظه، در بازگشت، سیگنال تعدیلی میفرستد
- اگر فعالیت نورونی بیش از حد باشد، نورونهای گاباارژیک (مهاری) فعال میشوند و تعادل را برقرار میکنند.
⛓️ این هماهنگی بین نورونهای تحریککننده و مهارکننده معادل Layer Normalization است: حفظ پایداری شبکه عصبی.
🔹 گام ۵: Output Prediction — بعد از این؟
در GPT، خروجی مدل برداریست که با تمام واژگان مقایسه میشود.
در مغز، نورونهایی که بیشتر آمادهی شلیک هستند (high excitability) احتمالاً کلمهی بعدی را تولید میکنند.
👂 مثلاً:
- شنیدن «او نامه را…» → فعالشدن نورونهایی که در گذشته با «نوشت»، «خواند»، «فرستاد» همراه بودند.
- نورونی که سریعتر به آستانه برسد، پیشبینی را شکل میدهد.
این یعنی پیشبینی مغز هم تابعیست از شباهت، تجربه، و پویایی نورونی — درست مثل خروجی Softmax در مدل.
📚 در پایان: فلسفهی عصبی-زبانی
هوش مصنوعی، با بردار میسازد، اما مغز با ولتاژ.
هوش مصنوعی، attention را با عدد میدهد، اما مغز با دوپامین.
هوش مصنوعی، موقعیت را با سینوس و کسینوس میسازد، اما مغز با زمان و اسپایک.
اما هدف یکیست:
معنا بخشیدن، فهمیدن، و ساختن زبان.
📌 #فلسفههوشمصنوعی
📌 #مدلزبانی #نورون #سیناپس #یادگیریعمیق #مغز #GPT #LLM #Neuroscience #Embeddings #Attention #Sodium #Calcium