🧠🔬 ترنسفورمر؛ معماری بنیادین مدلهای زبانی بزرگ
در سالهای اخیر، مدلهایی مانند ChatGPT توانستهاند تحولی بنیادین در حوزهی پردازش زبان طبیعی و تعامل انسانـماشین ایجاد کنند.
قلب تپندهی این مدلها، معماریای است به نام ترنسفورمر (Transformer) که نخستینبار در سال ۲۰۱۷ توسط پژوهشگران گوگل معرفی شد.
📚 نحوهی عملکرد مدلهای مبتنی بر ترنسفورمر
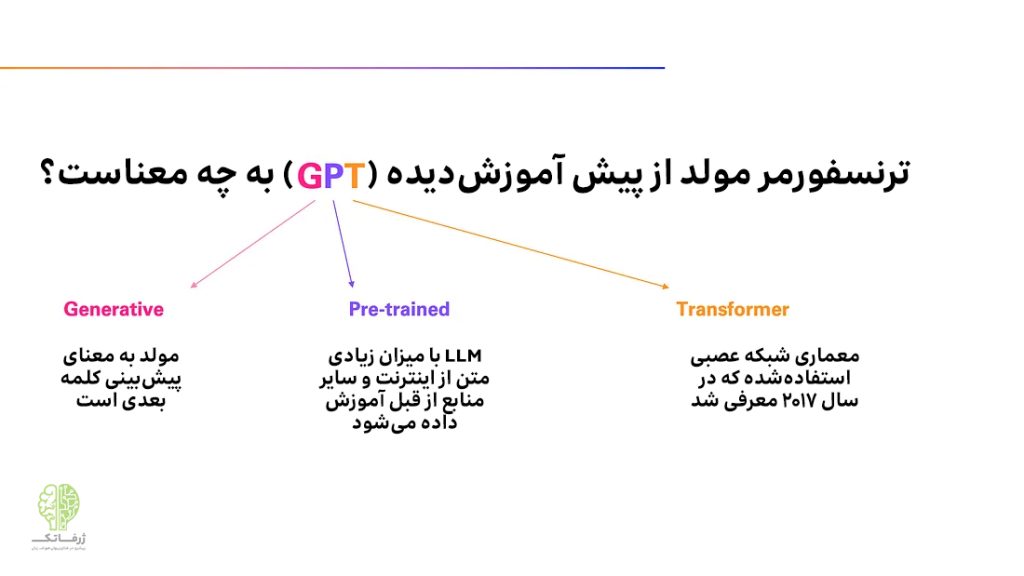
مدلهایی مانند GPT (مخفف Generative Pre-trained Transformer) بر پایهی سه اصل کلیدی طراحی شدهاند:
✅ Generative – توانایی تولید متنی جدید و معنادار
✅ Pre-trained – آموزش اولیه بر پایهی حجم عظیمی از دادهها
✅ Transformer – ساختار شبکهای نوین که متن را بهصورت غیرخطی و بر اساس مکانیسم توجه (Attention) پردازش میکند
🔍 مراحل پردازش متن در معماری ترنسفورمر بهصورت خلاصه:
🔸 توکنسازی: شکستن متن به واحدهای کوچکتر به نام توکن
🔸 تبدیل عددی (Embedding): نگاشت هر توکن به یک بردار عددی در فضای چندبُعدی
🔸 مکانیسم توجه (Attention): بررسی رابطهی بین توکنها و درک بهتر از زمینهی جمله
🔸 پردازش لایهبهلایه: استفادهی تکراری از توجه و لایههای عصبی پیشخور (Feed Forward) برای غنیسازی معنایی
🔸 پیشبینی توکن بعدی: مدل با کمک تابع Softmax توزیع احتمالاتی میسازد و مناسبترین توکن بعدی را انتخاب میکند
🧮 ریاضیات در قلب هوش مصنوعی
تمام این فرایند، بر پایهی ریاضیات استوار است:
بردارها، ضربهای ماتریسی، ضرب داخلی (Dot Product)، و توابعی مانند Softmax
همه در خدمت پردازشی هستند که در ظاهر ساده، اما در باطن بسیار پیچیده و قدرتمند است.
📌 در آینده، به بررسی عمیقتر اجزای کلیدی این معماری همچون توجه چندسر (Multi-Head Attention)**، **رمزگذاری موقعیت (Positional Encoding) و نحوهی آموزش این مدلها خواهیم پرداخت.
📎 منبع: خلاصهای از ویدیوی تحلیلی
“Transformers (how LLMs work) explained visually | DL5”